El curso
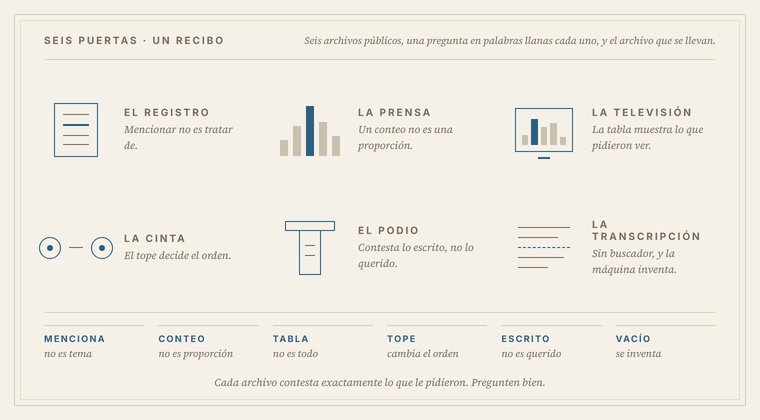
Los archivos públicos de Estados Unidos no esperan a nadie: el registro oficial del gobierno, veinte años de transcripciones de una cadena de noticias, cada palabra pública de cada presidente desde 1789, la televisión monitoreada hora por hora. Están abiertos, y casi nadie entra, porque la puerta es una API y una API parece cosa de programadores. Este curso abre nueve de esas puertas delante de ustedes, una por lección. En cada una ustedes escriben la pregunta en palabras llanas, una IA escribe el código, el código corre en Colab, y la respuesta vuelve como un archivo que es suyo, con la fecha y la consulta escritas adentro. Seis de los nueve archivos no piden cuenta ni cobran un centavo; los otros tres regalan su clave, y las dos ventanillas de GovInfo abren con la misma. Lo que todos piden es criterio: la ventana de tiempo, la palabra, el tope de filas y la colección son decisiones de ustedes, y cada lección muestra en pantalla el momento en que una decisión descuidada cambia la respuesta. Una columna que vuelve vacía, una tabla que se corta en treinta y dos filas, una máquina que inventa un dato que la página nunca tuvo: nada de eso se editó. Se resolvió delante de ustedes, porque ahí está la técnica.
Curriculum
-
-
(Included in full purchase)
Empieza aquí: cómo funciona este curso
-
(Included in full purchase)
-
-
(Included in full purchase)
I01 · La API del Federal Register
-
(Included in full purchase)
I02 · La API de Media Cloud
-
(Included in full purchase)
I03 · La API del Congressional Record de GovInfo
-
(Included in full purchase)
I04 · La API de la Compilation of Presidential Documents de GovInfo
-
(Included in full purchase)
I05 · El archivo de Reddit de Arctic Shift
-
(Included in full purchase)
I06 · La API de GDELT TV
-
(Included in full purchase)
I07 · El Archivo de TV del Internet Archive
-
(Included in full purchase)
I08 · El American Presidency Project
-
(Included in full purchase)
I09 · El Archivo de Transcripciones de CNN
-
(Included in full purchase)
¿Quieren aprender esto de quien les vende el acceso?
Las plataformas que revenden datos públicos les entregan una gráfica pulida y se guardan la consulta, el tope y la fecha. Su negocio triunfa cuando ustedes dependen de ellas. Este curso triunfa cuando ustedes pueden ir al archivo original, hacer la pregunta con sus propias palabras y decir de dónde salió cada número, incluso cuando el número les lleva la contraria. Aquí no hay intermediario: cada lección corre contra el archivo mismo, con el código a la vista, y se va a casa en un cuaderno que ustedes pueden cambiar.
Diego Bonilla, Ph.D.
Profesor titular de Comunicación Yo empecé en el internet en español antes de que hubiera qué vender en él: una revista literaria en línea, la tercera empresa de internet de México, el primer libro de mercadotecnia en internet escrito en nuestro idioma. Luego me fui a estudiar el otro lado de la pantalla, y el trabajo que hago desde entonces ha cambiado de nombre cuatro veces: alfabetización informática, alfabetización informacional, alfabetización digital, y ahora alfabetización en IA. En 2003 mi doctorado en Syracuse midió lo que una máquina puede inferir de una persona por los rastros que deja, y lo que encontré me llevó a crear un curso universitario de privacidad que sigo enseñando veinte años después. En 2007 y 2009 serví en el comité de ETS en Princeton que fijó el estándar nacional de alfabetización digital, y del 2014 al 2016 fui el embajador de alfabetización digital del sistema de universidades estatales de California. Cuatro nombres, un solo oficio: que la máquina más nueva no los agarre desarmados. También he trabajado del otro lado del mostrador. Desde el año 2000 hago cine que una máquina arma, distinto para cada espectador; la primera de esas películas ganó el primer premio en el Festival Internacional de Cine de Moscú, dos décadas antes de que la industria vendiera un modelo generativo. Big Data, un poema en video generativo hecho con el poeta Rodolfo Mata de la UNAM, quedó en la antología definitiva del campo y se expuso en Sacramento y en Estambul, y en 2025 mi trabajo en realidad virtual ganó un premio en un festival de cine de IA. Como investigador, mi trabajo reciente publicado es sobre IA y elecciones, y sobre cómo estos modelos representan a las culturas latinoamericanas, que es exactamente la pregunta que esta región tiene que hacerle a una tecnología entrenada en otra parte. Hoy doy clase de posgrado en la UNAM, y las máquinas que este curso explica corren a diario bajo mis manos: ellas hicieron las imágenes y las voces que van a ver adentro. Los vendedores llevan dos años enseñando alfabetización en IA, porque antes no había nada que vender. No estoy en contra de ellos. Simplemente no soy uno de ellos, y esa es la diferencia que ustedes están comprando. Este curso no está traducido: lo escribí en español, para la región, porque así empecé y a esto vuelvo. Doctorado, Syracuse University · Profesor titular, Sacramento State · Profesor de posgrado, UNAM · Comité iSkills de ETS, Princeton, 2007 y 2009 · Embajador de alfabetización digital, CSU, 2014-2016 · Big Data en la Electronic Literature Collection, expuesto en Estambul · Investigación publicada sobre la representación de culturas latinoamericanas con IA
Cuentas claras
Un curso sobre evidencia debe aguantar que le pidan la suya. Cada cifra que se ve en pantalla salió de la corrida que están viendo, con la consulta y la fecha guardadas en el mismo archivo que se llevan. Cuando un archivo contestó mal, eso se quedó en la lección: la columna vacía del Federal Register, el tope silencioso de GDELT, el dato que una IA inventó sobre una transcripción de CNN. Las nueve lecciones del rediseño están aquí, cada una pasó el mismo control antes de entrar, y el precio no cambia. Y cada lección cierra con un cuaderno que corre, la instrucción escrita en palabras para pedirle la técnica a una IA, y los resultados de la corrida en un archivo, para que la próxima pregunta sea la de ustedes.
Nueve archivos abiertos, y el recibo de cada respuesta.
Nueve lecciones, cada una con un archivo público, la pregunta en palabras llanas, el código que la IA escribió y lo que ese archivo no puede decirles.